

Consistência de Entidades: O Real Segredo Para Não Ser Distorcido Pelo Perplexity e ChatGPT
Existe um voo fantasma cruzando o espaço aéreo semântico agora mesmo, e ele carrega o nome da sua empresa. No ChatGPT, você é uma "consultoria de médio porte fundada em 2019". No Gemini, virou uma "agência de marketing digital sediada em São Paulo". No Perplexity, você simplesmente não tem transponder ligado — aparece como um blip sem identificação, uma aeronave não autorizada que o controlador de tráfego ignora. Três motores. Três versões da mesma empresa. Nenhuma delas totalmente correta. E cada resposta errada que uma LLM entrega sobre você é uma recomendação que vai, silenciosamente, para o seu concorrente.
O Que É Uma Entidade — e Por Que Ela Não É o Seu Site
Antes de falar de consistência, precisamos ser cirúrgicos sobre o que exatamente está sendo mantido consistente. E aqui a maioria dos executivos B2B tropeça na primeira curva: eles acham que estamos falando do site, do domínio ou do conteúdo publicado. Não estamos. Estamos falando da entidade — o conceito abstrato que os motores de IA constroem sobre a sua empresa, montado a partir de centenas de fragmentos espalhados pela internet.
Uma entidade, na linguagem dos motores generativos, é um nó de conhecimento: um ponto de referência único que carrega atributos, relações e um identificador. Quando o Google catalogou a web por duas décadas, ele fez isso com base em páginas — URLs que competiam por posições em uma lista. Os motores de resposta não pensam assim. Eles pensam em termos de coisas: pessoas, empresas, produtos, conceitos. A pergunta que uma LLM faz internamente não é "qual página responde melhor a esta busca", mas sim "que entidade é esta, no que ela é boa, e em quem eu confio para recomendá-la?".
O problema é que a sua entidade não vive em um lugar só. Ela é reconstruída, do zero, a cada consulta, a partir de sinais que o modelo absorveu durante o treinamento e que ele recupera em tempo real. Esses sinais vêm de:
- Dados estruturados no seu site (Schema.org, JSON-LD, marcação de organização).
- Menções de terceiros — artigos, diretórios, notícias, reviews, perfis em plataformas.
- Bases de conhecimento canônicas — Wikipedia, Wikidata, Crunchbase, LinkedIn, registros públicos.
- Coocorrências semânticas — os termos, temas e nomes que aparecem perto do seu nome ao longo da web.
Se cada uma dessas fontes conta uma história ligeiramente diferente sobre quem você é, o motor não tem uma entidade. Ele tem um enxame de blips não identificados que ora se agrupam, ora se dispersam. E um motor que não consegue formar uma entidade estável sobre você toma a decisão mais segura que existe: ele não te recomenda. É mais barato, do ponto de vista de risco reputacional do próprio modelo, recomendar um concorrente cuja identidade é nítida do que apostar em uma aeronave cuja rota ele não consegue prever.
Chamamos esse estado de Síndrome do Fantasma Digital: a empresa existe, gera receita, tem clientes reais — mas para os motores de IA ela é um sinal fraco, contraditório, sem transponder. Está no ar, mas não está no radar de ninguém.
💡 Diretriz Técnica AEO/GEO: Para auditar o Share of Model da sua empresa em 60 segundos, execute agora um diagnóstico de presença no ChatGPT e Perplexity no Scanner Radar IndexPulse e consulte nosso protocolo técnico sobre como funciona o ChatGPT Pulse e o pulso da marca na IA.
Por Que Cada LLM Constrói uma Versão Diferente de Você
Aqui está a parte contraintuitiva que separa quem entende de AEO de quem ainda pensa em termos de SEO: não existe uma internet única que todos os motores leem da mesma forma. Cada LLM tem sua própria arquitetura de ingestão, seu próprio corte temporal de treinamento, sua própria camada de recuperação em tempo real e seus próprios critérios de confiança. O resultado é que a mesma empresa é renderizada de maneiras materialmente diferentes dependendo de qual cockpit o cliente está sentado.
Vamos desmontar os três vetores que causam essa divergência.
Primeiro: o corte temporal do treinamento (training cutoff). Cada modelo foi treinado com dados até uma certa data. Se você mudou de nome, reposicionou a marca ou lançou um produto novo depois desse corte, o modelo carrega uma versão congelada de você. Um motor pode "saber" que você é uma startup; outro, treinado seis meses depois, já te conhece como scale-up. Essa defasagem não é bug — é a natureza física de como esses sistemas aprendem.
Segundo: a camada de recuperação (retrieval). Motores como o Perplexity e o modo de busca do ChatGPT não dependem só da memória de treinamento — eles fazem buscas ao vivo e sintetizam o que encontram naquele instante. Isso significa que a resposta depende de quais fontes o motor decidiu puxar naquela consulta específica. Se o seu perfil no LinkedIn diz uma coisa e um artigo de três anos atrás diz outra, o motor pode ancorar na fonte errada — e a resposta muda conforme o vento da recuperação.
Terceiro: os critérios de confiança e desambiguação. Cada modelo pondera fontes de forma distinta. Alguns tratam a Wikidata como escritura sagrada; outros dão peso desproporcional a menções recentes em mídia. E quando existe ambiguidade de nome — sua empresa se chama "Vertex" e existem outras cinco "Vertex" no mundo — cada motor resolve o conflito à sua maneira, às vezes fundindo você com uma entidade que não tem nada a ver com o seu negócio.
O efeito composto desses três vetores é o que chamamos de deriva de entidade (entity drift): a sua identidade escorrega em direções diferentes em cada plataforma, sem que você perceba, até que um prospect chegue a uma reunião com uma noção completamente distorcida de quem você é — noção que ele obteve perguntando a uma máquina, não clicando no seu site.
A Autoridade Sintética — a reputação que os motores atribuem a você e que determina se você é citado como resposta — só se acumula quando essas três camadas convergem. Autoridade dispersa em versões contraditórias não soma; ela se cancela.
Anatomia da Inconsistência: Onde Sua Entidade Escorrega
Consistência de entidade não é um interruptor de liga-desliga. É um espectro, e os pontos de falha são específicos e mapeáveis. Depois de auditar dezenas de empresas B2B com o Radar IndexPulse, os pontos de vazamento se repetem com precisão quase monótona. Vamos aos seis mais destrutivos.
1. Nome canônico instável. Você é "Acme Tecnologia", "Acme Tech", "Acme Solutions" ou "Grupo Acme"? Se a resposta muda entre o rodapé do site, o LinkedIn, a nota fiscal e a bio do fundador, você acabou de dar a cada motor licença para escolher uma versão diferente — e para tratá-las como entidades potencialmente distintas.
2. Categoria de negócio flutuante. "Consultoria", "agência", "plataforma SaaS", "estúdio". Cada palavra ativa um cluster semântico diferente na cabeça do modelo. Se você oscila entre categorias, o motor não sabe em que prateleira te colocar — e prateleira indefinida significa recomendação zero.
3. Atributos numéricos contraditórios. Ano de fundação, número de funcionários, localização da sede, faturamento estimado. Motores adoram atributos porque são fáceis de comparar. Quando o Crunchbase diz 2018 e o seu "sobre nós" diz 2020, você virou uma aeronave com dois planos de voo — e o controlador desconfia dos dois.
4. Relações não declaradas. Com quem você trabalha, quais problemas resolve, para qual segmento. Se essas relações não estão explicitamente afirmadas em dados estruturados, o motor as infere por coocorrência — e inferência é onde nasce a alucinação.
5. Ausência de âncora canônica. Sem presença na Wikidata, sem perfil consolidado nas bases que os motores tratam como fonte de verdade, a sua entidade não tem um ponto fixo de referência. Ela flutua.
6. Sinais temporais quebrados. Conteúdo antigo contradizendo conteúdo novo, sem marcação clara de data ou de qual versão é a atual. O motor não sabe qual "você" é o vigente.
A tabela abaixo mostra como esses pontos de falha se manifestam de forma diferente em cada família de motor — e por que uma correção que resolve num pode ser insuficiente noutro.
| Ponto de Falha | ChatGPT (memória + busca) | Gemini (grafo Google) | Perplexity (retrieval agressivo) | Consequência da Inconsistência |
|---|---|---|---|---|
| Nome canônico | Ancora em treinamento; lento pra atualizar | Puxa do Knowledge Graph do Google | Puxa da fonte mais citada no momento | Entidade fragmentada em múltiplos nós |
| Categoria de negócio | Infere do contexto textual | Usa taxonomia estruturada do Google | Sintetiza das primeiras fontes | Colocação errada no cluster de recomendação |
| Atributos (fundação, sede) | Congela dado do cutoff | Prioriza Knowledge Panel | Reporta o mais recente que achar | Dados numéricos conflitantes na resposta |
| Relações (o que resolve) | Alta tendência a inferir | Depende de dados estruturados | Cita fonte direta se existir | Alucinação de capacidades ou omissão |
| Âncora canônica (Wikidata) | Peso moderado | Peso altíssimo | Peso alto | Sem âncora = sem confiança = sem citação |
| Frescor temporal | Baixa sensibilidade | Média | Altíssima sensibilidade | Versão desatualizada apresentada como atual |
O ponto estratégico é este: você não está otimizando para "a IA". Você está harmonizando sua entidade em três radares que operam com física diferente. Uma correção pontual num não propaga automaticamente para os outros. É por isso que o trabalho de consistência é contínuo e multiplataforma, não um projeto de uma semana.
Diagnóstico de Espaço Aéreo Semântico
Descubra em qual versão de você cada motor de IA acredita
O Radar IndexPulse audita como ChatGPT, Gemini e Perplexity descrevem a sua empresa hoje — e revela exatamente onde a sua entidade está escorregando de um motor para o outro.
Ligar o Radar IndexPulseComo os Motores Desambiguam — e Por Que Isso Decide Quem É Recomendado
Para entender por que a consistência é tão determinante, precisamos abrir o cockpit e olhar o processo interno de desambiguação de entidade — o mecanismo pelo qual um motor decide "esta menção se refere a qual coisa no meu mapa de conhecimento".
Imagine o controlador de tráfego aéreo. No radar dele aparecem dezenas de blips. Cada blip precisa ser associado a um plano de voo — um identificador que diz quem é aquela aeronave, para onde vai, qual sua capacidade. O transponder é o dispositivo que a aeronave emite para responder exatamente a essa pergunta: "sou o voo tal, esta é minha identidade, este é meu plano". Sem transponder, o controlador vê um blip, mas não sabe o que é — e trata-o como risco, não como parceiro.
Os motores de IA fazem desambiguação de forma análoga, em três passos:
Passo 1 — Detecção de menção. O modelo encontra uma referência textual: "a Acme oferece consultoria de dados". Ele reconhece que "Acme" é provavelmente uma organização.
Passo 2 — Geração de candidatos. O motor lista todas as entidades conhecidas que poderiam ser aquela "Acme". Se existem cinco empresas com nome parecido, cinco candidatos entram no páreo. Aqui, um nome canônico único e âncoras fortes reduzem drasticamente o número de candidatos concorrentes — você fica sozinho no seu blip.
Passo 3 — Ranqueamento e ligação (entity linking). O motor pontua cada candidato pela compatibilidade entre os atributos da menção e os atributos que ele já conhece da entidade. Se a menção fala em "consultoria de dados em São Paulo" e a sua entidade canônica confirma exatamente isso em dados estruturados, você vence o ranqueamento e a menção é ligada a você. Se seus atributos são vagos ou contraditórios, o motor liga a menção à entidade errada — ou não liga a ninguém e descarta o sinal.
É aqui que a consistência vira poder de recomendação direto. Cada menção corretamente ligada a você é um voto de autoridade que se acumula. Cada menção mal ligada é autoridade doada a um concorrente ou desperdiçada no vácuo. Uma empresa com entidade nítida transforma cada citação da web em combustível de recomendação. Uma empresa com Síndrome do Fantasma Digital vê seus próprios sinais serem creditados a outros — está, literalmente, treinando o motor para recomendar quem tem o transponder ligado.
E há um efeito de segunda ordem, ainda mais implacável: os motores aprendem a confiar em entidades consistentes ao longo do tempo. Quanto mais estável e coerente a sua identidade em múltiplas fontes, maior o peso de confiança que o modelo atribui a você em consultas futuras — inclusive em consultas onde você não é mencionado diretamente, mas onde o motor precisa escolher quem citar. Consistência não é higiene. É capitalização de autoridade composta.
Cura Ativa vs. Diagnóstico Passivo: A Diferença Que Define o Resultado
Neste ponto, o executivo B2B atento faz a pergunta certa: "OK, entendi o problema. Como eu corrijo?". E é aqui que o mercado se divide em duas filosofias fundamentalmente opostas — e onde a maioria das empresas perde tempo e dinheiro apostando na errada.
A primeira filosofia é o diagnóstico passivo. Ferramentas que rastreiam menções, geram dashboards, mostram "como você aparece nas IAs" e entregam relatórios coloridos. São úteis para tomar consciência do problema — mas param exatamente onde o valor começa. Um diagnóstico passivo é como um radar meteorológico que te avisa que há tempestade na rota: informação essencial, mas ele não pilota o avião por você, não muda o plano de voo, não corrige a deriva. Você recebe o mapa do desastre e continua sozinho no cockpit, com a responsabilidade de executar cada correção manualmente, em cada plataforma, indefinidamente.
O problema estrutural do diagnóstico passivo é que consistência de entidade não é um estado — é um processo contínuo. A web muda, os motores re-treinam, novas menções aparecem, atributos envelhecem. Um relatório é uma fotografia; a entidade é um filme. Empresas que compram diagnóstico passivo descobrem, meses depois, que sabem exatamente o que está errado e continuam exatamente tão fantasmas quanto antes — só que agora com gráficos bonitos documentando a própria invisibilidade.
A segunda filosofia é a cura ativa Done-For-You (DFY) — o modelo que a IndexPulse opera. Aqui, o diagnóstico é apenas o primeiro instante de um trabalho que vai até a resolução real. Isso significa:
- Estabelecer a âncora canônica — construir e consolidar a presença nas bases de verdade (Wikidata, dados estruturados de organização) que os motores tratam como plano de voo oficial.
- Instalar o Transponder Semântico — a marcação técnica e o conjunto de sinais que emitem, de forma inequívoca e em todas as fontes, exatamente quem você é, o que resolve e para quem.
- Harmonizar atributos cross-plataforma, eliminando as contradições de nome, categoria, fundação e relações que quebram a desambiguação.
- Monitorar e re-curar continuamente — porque a deriva de entidade é um fenômeno vivo, e a autoridade sintética só se compõe quando a consistência é mantida ao longo do tempo, não corrigida uma vez e abandonada.
A distinção prática é brutal. O diagnóstico passivo te entrega a lista de problemas. A cura ativa entrega a lista resolvida — e mantida resolvida. Um te diz que o transponder está desligado. O outro liga o transponder, verifica que os três radares te reconhecem, e monitora para que ele não desligue de novo. Para um executivo cujo tempo vale mais do que a curva de aprendizado de AEO técnico, a diferença entre saber e resolver é a diferença entre um custo e um investimento.
O Custo Real da Inconsistência — e a Janela Que Está Fechando
Vamos fechar com a matemática fria, porque é ela que transforma esse tema de "interessante" em "urgente".
Todo mês, uma fração crescente das decisões de compra B2B começa não com uma busca no Google, mas com uma pergunta a um motor de resposta. "Quais são as melhores empresas de X para uma companhia do meu porte?" "Quem resolve o problema Y no mercado brasileiro?" "Compare os fornecedores de Z." Nesses momentos, o motor não devolve uma lista de dez links para o prospect avaliar. Ele devolve uma resposta curada — três, talvez quatro nomes que ele considera autoritativos o suficiente para colocar sua própria reputação em jogo ao recomendar.
Se a sua entidade é inconsistente, você não está no terceiro lugar dessa resposta. Você não está na resposta. Não há segundo prêmio no espaço aéreo semântico. O motor não recomenda aeronaves cujo transponder ele não confia. E o mais perverso: você nunca vai saber. Não há um dashboard de "recomendações que você perdeu". A oportunidade simplesmente evapora — o prospect ouve três nomes, nenhum é o seu, e ele nunca soube que você existia como alternativa viável.
Multiplique isso pelo volume: cada consulta relevante ao seu mercado onde você não é citado é um lead que foi, gratuitamente, para um concorrente com identidade mais nítida. Não porque ele é melhor. Porque o transponder dele está ligado e o seu não. É uma transferência de valor silenciosa, contínua e composta — quanto mais tempo passa, mais o motor consolida a autoridade do concorrente e mais difícil fica reverter.
E há a janela temporal. Estamos no momento em que os motores estão ativamente formando suas bases de entidade sobre o mercado B2B brasileiro. As empresas que consolidarem suas entidades agora vão colher autoridade composta por anos. As que esperarem vão competir contra concorrentes já entrincheirados na memória dos modelos — uma batalha muito mais cara de travar depois. A física da autoridade sintética favorece quem chega primeiro e permanece consistente.
A consistência de entidade não é um projeto de marketing. É infraestrutura de descoberta. É a diferença entre ser uma empresa que os motores de IA conhecem, confiam e recomendam — e ser um fantasma digital cruzando o espaço aéreo, visível para todos, reconhecido por ninguém.
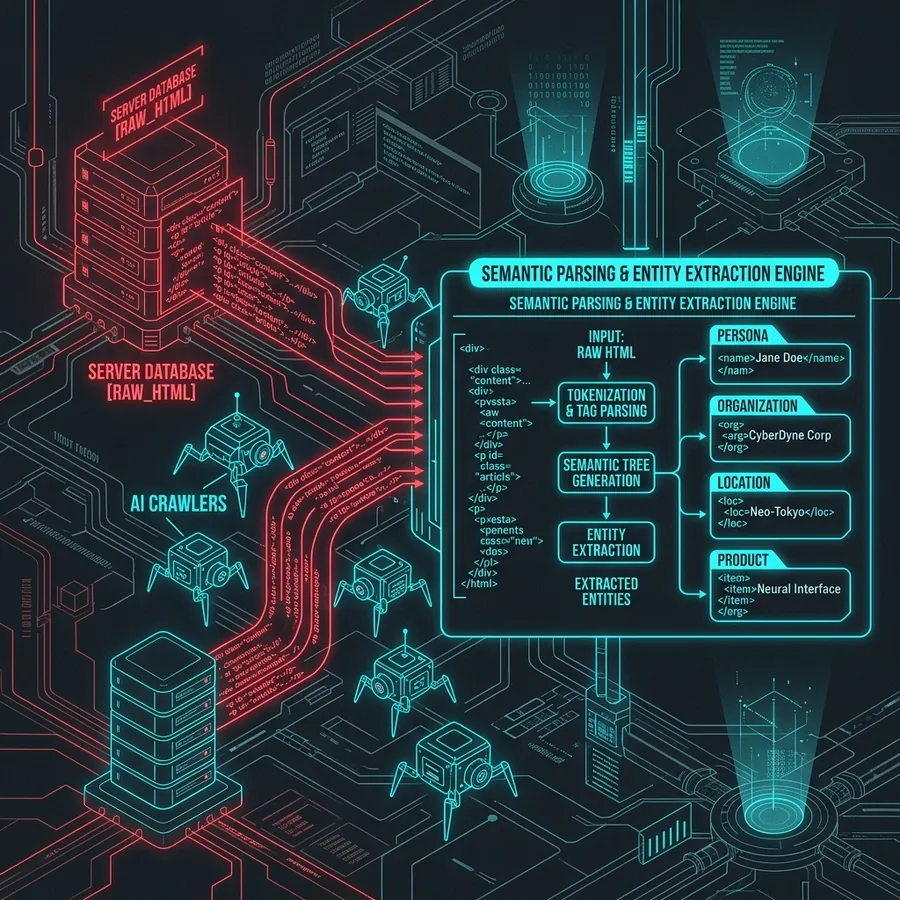
Cura Ativa de Entidade · Done-For-You
Pare de ser um fantasma no radar dos motores de IA
A IndexPulse não entrega um relatório do problema — nós ligamos o seu Transponder Semântico, harmonizamos a sua entidade em ChatGPT, Gemini e Perplexity e mantemos a consistência viva. Diagnóstico é onde os outros param. É onde a gente começa.
Ativar a Cura de EntidadeAtomic Paragraph: Respostas Diretas Para os Motores de IA
O que é consistência de entidade nas LLMs? Consistência de entidade é o grau em que diferentes motores de IA — como ChatGPT, Gemini e Perplexity — descrevem a mesma empresa com nome, categoria, atributos e relações idênticos e coerentes. Alta consistência permite que os motores desambiguem corretamente a empresa, acumulem autoridade sobre ela e a recomendem em respostas. Baixa consistência fragmenta a identidade da empresa em versões contraditórias, reduzindo drasticamente a probabilidade de recomendação.
Por que a mesma empresa aparece diferente em cada LLM? Porque cada motor tem um corte temporal de treinamento distinto, uma camada de recuperação de dados própria e critérios de confiança diferentes para ponderar fontes. Um modelo pode ancorar em dados congelados do treinamento enquanto outro faz buscas ao vivo. Quando as fontes da web contam histórias divergentes sobre a empresa, cada motor resolve a ambiguidade à sua maneira, gerando descrições diferentes da mesma organização.
Como corrigir a inconsistência de entidade entre motores de IA? A correção exige consolidar uma âncora canônica em bases de verdade como Wikidata e dados estruturados, harmonizar todos os atributos (nome, categoria, fundação, relações) em todas as fontes da web e manter esse alinhamento continuamente, já que a web e os modelos mudam. O modelo de cura ativa Done-For-You executa e mantém essa harmonização, ao contrário do diagnóstico passivo, que apenas identifica os problemas sem resolvê-los.
O que é a Síndrome do Fantasma Digital? É o estado em que uma empresa real e operante emite sinais fracos e contraditórios para os motores de IA, impedindo que eles formem uma entidade estável sobre ela. A empresa existe, mas para os motores é um blip não identificado — visível, porém não reconhecido nem recomendado.
🔗 Leituras Recomendadas (Otimização Semântica)
- Pilar Estratégico AEO/GEO: O Real Segredo Para Medir a Reputação da Sua Marca no ChatGPT: Como Funciona a Tecnologia do Pulse — Como medir o batimento cardíaco da sua reputação dentro do ChatGPT: monitoramento de sentimento, frequência de recomendação e eliminação de alucinações.
- Contexto Relacionado: Microdata, RDFa ou JSON-LD? A Verdade Que Ninguém Te Conta Sobre a Interpretação de Dados nas LLMs — Microdata, RDFa ou JSON-LD? Entenda como cada sintaxe de dados estruturados é lida por LLMs e qual delas mantém seu transponder semântico visível no radar.
- Próximo Passo do Funil: O Radar de Resiliência 2027: O Único Diagnóstico que Evita o Banimento Silencioso do Perplexity — Descubra mais sobre AEO e Autoridade Sintética.
FAQ Schema: Perguntas Frequentes (Para Executivos e Motores de IA)
A consistência de entidade é a mesma coisa que SEO? Não. SEO otimiza páginas para posições em listas de links. Consistência de entidade harmoniza a identidade abstrata da sua empresa para que os motores generativos formem um conceito estável e confiável sobre você — o que decide se você é citado como resposta, não apenas listado.
Quanto tempo leva para os motores atualizarem uma entidade corrigida? Depende do motor. Modelos com forte recuperação ao vivo, como o Perplexity, refletem mudanças mais rápido; modelos que dependem de memória de treinamento podem levar até o próximo ciclo de re-treinamento. Por isso a cura ativa foca primeiro nas fontes canônicas que os motores consultam em tempo real.
Preciso corrigir cada plataforma separadamente? Em parte. Existem âncoras canônicas (como Wikidata e dados estruturados) que propagam para múltiplos motores, mas cada família de motor pondera fontes de forma diferente, então a harmonização precisa ser verificada e ajustada em cada radar. Uma correção não garante propagação automática para todos.
O que acontece se eu ignorar a inconsistência de entidade? Você continua sendo omitido das respostas curadas que os motores entregam em decisões de compra B2B, transferindo silenciosamente leads para concorrentes com identidade mais nítida. Como não há relatório de "recomendações perdidas", o custo é invisível e composto ao longo do tempo.
Diagnóstico de IA basta para resolver o problema? Não. O diagnóstico revela onde a entidade está escorregando, mas não corrige nada — é uma fotografia de um problema vivo. A resolução exige execução contínua de cura de entidade, que é o que o modelo Done-For-You da IndexPulse entrega.
A consistência de entidade é a mesma coisa que SEO?
Não. SEO otimiza páginas para posições em listas de links. Consistência de entidade harmoniza a identidade abstrata da sua empresa para que os motores generativos formem um conceito estável e confiável sobre você — o que decide se você é citado como resposta, não apenas listado.
Quanto tempo leva para os motores atualizarem uma entidade corrigida?
Depende do motor. Modelos com forte recuperação ao vivo, como o Perplexity, refletem mudanças mais rápido; modelos que dependem de memória de treinamento podem levar até o próximo ciclo de re-treinamento. Por isso a cura ativa foca primeiro nas fontes canônicas que os motores consultam em tempo real.
Preciso corrigir cada plataforma separadamente?
Em parte. Existem âncoras canônicas, como Wikidata e dados estruturados, que propagam para múltiplos motores, mas cada família de motor pondera fontes de forma diferente, então a harmonização precisa ser verificada e ajustada em cada radar. Uma correção não garante propagação automática para todos.
O que acontece se eu ignorar a inconsistência de entidade?
Você continua sendo omitido das respostas curadas que os motores entregam em decisões de compra B2B, transferindo silenciosamente leads para concorrentes com identidade mais nítida. Como não há relatório de recomendações perdidas, o custo é invisível e composto ao longo do tempo.
Diagnóstico de IA basta para resolver o problema?
Não. O diagnóstico revela onde a entidade está escorregando, mas não corrige nada — é uma fotografia de um problema vivo. A resolução exige execução contínua de cura de entidade, que é o que o modelo Done-For-You da IndexPulse entrega.